Il Manifesto — MEMA: Memoria Manifesta
MeMa: Memoria Manifesta
Richiesta del Cliente
L'archivio storico de il manifesto è ufficialmente riconosciuto dal Ministero della Cultura come bene di interesse culturale. Per portare questa eredità nell'era digitale, il manifesto sta sviluppando una nuova strategia basata sull'intelligenza artificiale — e ha scelto Isagog come partner di ricerca e sviluppo. Insieme, stiamo costruendo una piattaforma che trasforma decenni di storia giornalistica in una risorsa viva e consultabile per il futuro.
Sfide
MEMA è nato per progettare un'AI di comunità basata sui principi di apertura, trasparenza, collaborazione e non estrattività. La missione: stabilire relazioni produttive tra l'archivio, la redazione, le diverse comunità di utenti e la società nel suo insieme.
Trasformare il lavoro redazionale
L'archivio storico è una risorsa preziosa per la redazione del giornale. Tuttavia, consultarlo richiede spesso l'aiuto di un archivista. Oggi, MeMa offre uno strumento che semplifica la consultazione dell'archivio, facilitando il lavoro della redazione e migliorando la qualità complessiva del prodotto editoriale.
Arricchire l'esperienza di lettura
La funzione di ricerca semantica sarà presto disponibile anche per la più ampia comunità di lettori. Nel frattempo, MeMa mette già in luce connessioni tra gli articoli attuali e i pezzi dell'archivio storico. Queste connessioni appaiono come Consigli di MeMa nell'edizione online, offrendo ai lettori una chiave di lettura storica sulle notizie di oggi e arricchendo l'esperienza di lettura complessiva.
Sperimentare tecnologie in evoluzione
Le tecnologie della conoscenza e del linguaggio sono in continua evoluzione. La base di conoscenza di MeMa offre una preziosa opportunità per sperimentare nuove metodologie e strumenti. I risultati vengono condivisi con la comunità scientifica.
- Paper al Congresso Italiano di Linguistica Computazionale.
- A Venezia tra le radici e il futuro dell'Intelligenza Artificiale.
Architettura del sistema
Sviluppo
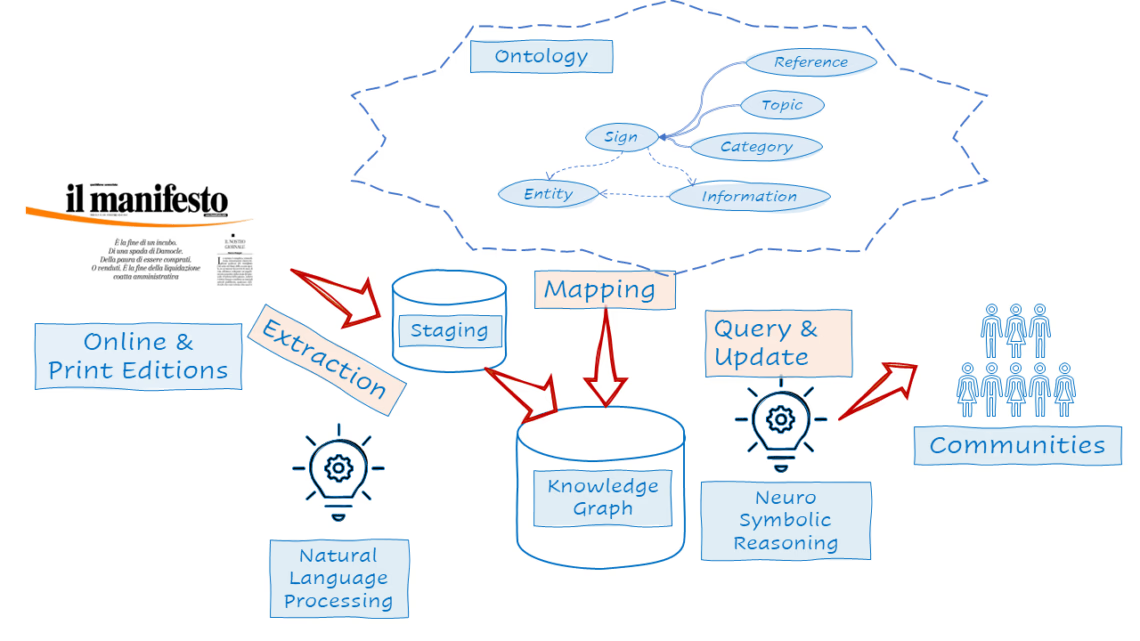
Ogni mattina, un processo di caricamento dati aggiorna il Knowledge Graph (KG) con nuovi contenuti. Questo processo integra fonti multiple, analizza il testo tramite un servizio NLP per estrarne le informazioni rilevanti e genera dati RDF allineati all'ontologia di MeMa per arricchire il KG. Il Knowledge Graph è un database a grafo basato sul modello RDF (Resource Description Framework), dotato di capacità inferenziali e costruito sulle seguenti tecnologie: Apache Jena, motore di inferenza OWL Pellet, motore di ricerca Lucene.
In parallelo, un servizio di Natural Language Processing (NLP) fornisce un livello di astrazione che supporta diverse funzioni analitiche fondamentali per il funzionamento del sistema, tra cui: riconoscimento delle entità, identificazione dei temi, analisi della similarità semantica, oltre ad altre attività NLP basate su modelli transformer open source.
Un servizio separato gestisce le interrogazioni e gli aggiornamenti al KG. Supporta sia ricerche per similarità sia query SPARQL per recuperare le entità rilevanti. Questo servizio sfrutta attributi indicizzati per migliorare le prestazioni delle query e velocizzare il recupero, utilizzando al contempo tecniche NLP per interpretare l'input dell'utente e classificare i risultati di conseguenza.